
La cámara se enciende, aparece brevemente en la grabadora y luego desaparece. Unos minutos después, la secuencia se repite. Cambiar el cable de conexión no soluciona el problema. Antes de descartar la cámara, compruebe si el conmutador está interrumpiendo su alimentación deliberadamente.
Un sistema de supervisión PoE normalmente monitoriza una condición configurada y activa una acción de recuperación cuando dicha condición falla. Según el producto, esto puede implicar una comprobación de accesibilidad y un reinicio. Si la condición está mal configurada, bloqueada o se evalúa antes de que finalice el arranque, la función de recuperación puede provocar una interrupción recurrente del servicio.
La tarea inmediata consiste en determinar quién inició el reinicio. La tarea a largo plazo es lograr que la regla de recuperación corresponda a una falla real del servicio. Una dirección IP accesible, una transmisión de video sin interrupciones y un dispositivo con alimentación estable están relacionados, pero no constituyen la misma observación.
Conserva la secuencia de eventos antes de cambiar el temporizador.
Recopile los eventos PoE disponibles del switch, el tiempo de actividad del dispositivo, los eventos del registrador y la configuración del temporizador de vigilancia. Confirme que sus relojes estén suficientemente sincronizados para comparar la secuencia. Si la cámara desaparece primero y el temporizador de vigilancia se reinicia después, esto sugiere una secuencia de eventos diferente a la del corte de energía del switch mientras la cámara estaba funcionando.
Busque un intervalo repetitivo. Si el ritmo de las interrupciones coincide con el intervalo de sondeo configurado, el umbral de sondeo fallido y el comportamiento de reinicio, esto constituye una pista útil. Esta pista se mantiene hasta que los registros o una prueba controlada vinculen la interrupción del suministro eléctrico con la acción del sistema de vigilancia.
Cuando sea operativamente aceptable, desactive temporalmente la recuperación automática del puerto de prueba afectado, manteniendo la alimentación PoE habitual. Observe si la cámara permanece activa. Realice el cambio mediante el proceso de mantenimiento aprobado, documéntelo y restaure la configuración revisada tras el diagnóstico. Un dispositivo estable durante esta prueba indica que la lógica de activación está en buen estado; no demuestra que la red en general funcione correctamente.
Lea la configuración como una secuencia, no como números aislados.
Las implementaciones de productos difieren. Por ejemplo,Manual de conmutadores gestionados de MoxaEste ejemplo documenta una comprobación de fallos de un dispositivo PoE con una dirección IP de destino, un periodo de comprobación, un número de respuestas fallidas y una acción. Explica los tipos de ajustes que se deben inspeccionar; no define los ajustes ni las capacidades de un modelo TODAHIKA.
Para el interruptor en sí, mapee la secuencia desde el encendido hasta la monitorización normal. Identifique cualquier retardo de arranque, el mecanismo de sondeo, el número de fallos necesarios, la duración del apagado y el período de espera para el reinicio. Pregunte qué sucede después de repetidas recuperaciones fallidas. Algunas implementaciones ofrecen más control que otras.
| Entorno o comportamiento | Pregunta para responder | El fracaso que puede crear |
|---|---|---|
| Dirección de destino | ¿Es esta la dirección actual prevista para el punto final? | Un dispositivo en buen estado se reinicia porque se está monitorizando una dirección antigua. |
| Sondear la fuente y la trayectoria | ¿Puede la sonda del propio conmutador alcanzar el objetivo? | Un ping exitoso realizado por un técnico oculta un problema de VLAN o enrutamiento en el switch. |
| subsidio inicial | ¿Cuándo comienza el conteo de fallas después de que se restablece el suministro eléctrico? | La cámara se reinicia antes de que termine de arrancar. |
| Umbral de fallo | ¿Qué duración del evento debería desencadenar una acción? | Una breve interrupción de la red provoca una recuperación innecesaria. |
| Política de reintentos | ¿La recuperación se detiene o se intensifica tras repetidos fallos? | El sistema entra en un bucle infinito y destruye pruebas útiles. |
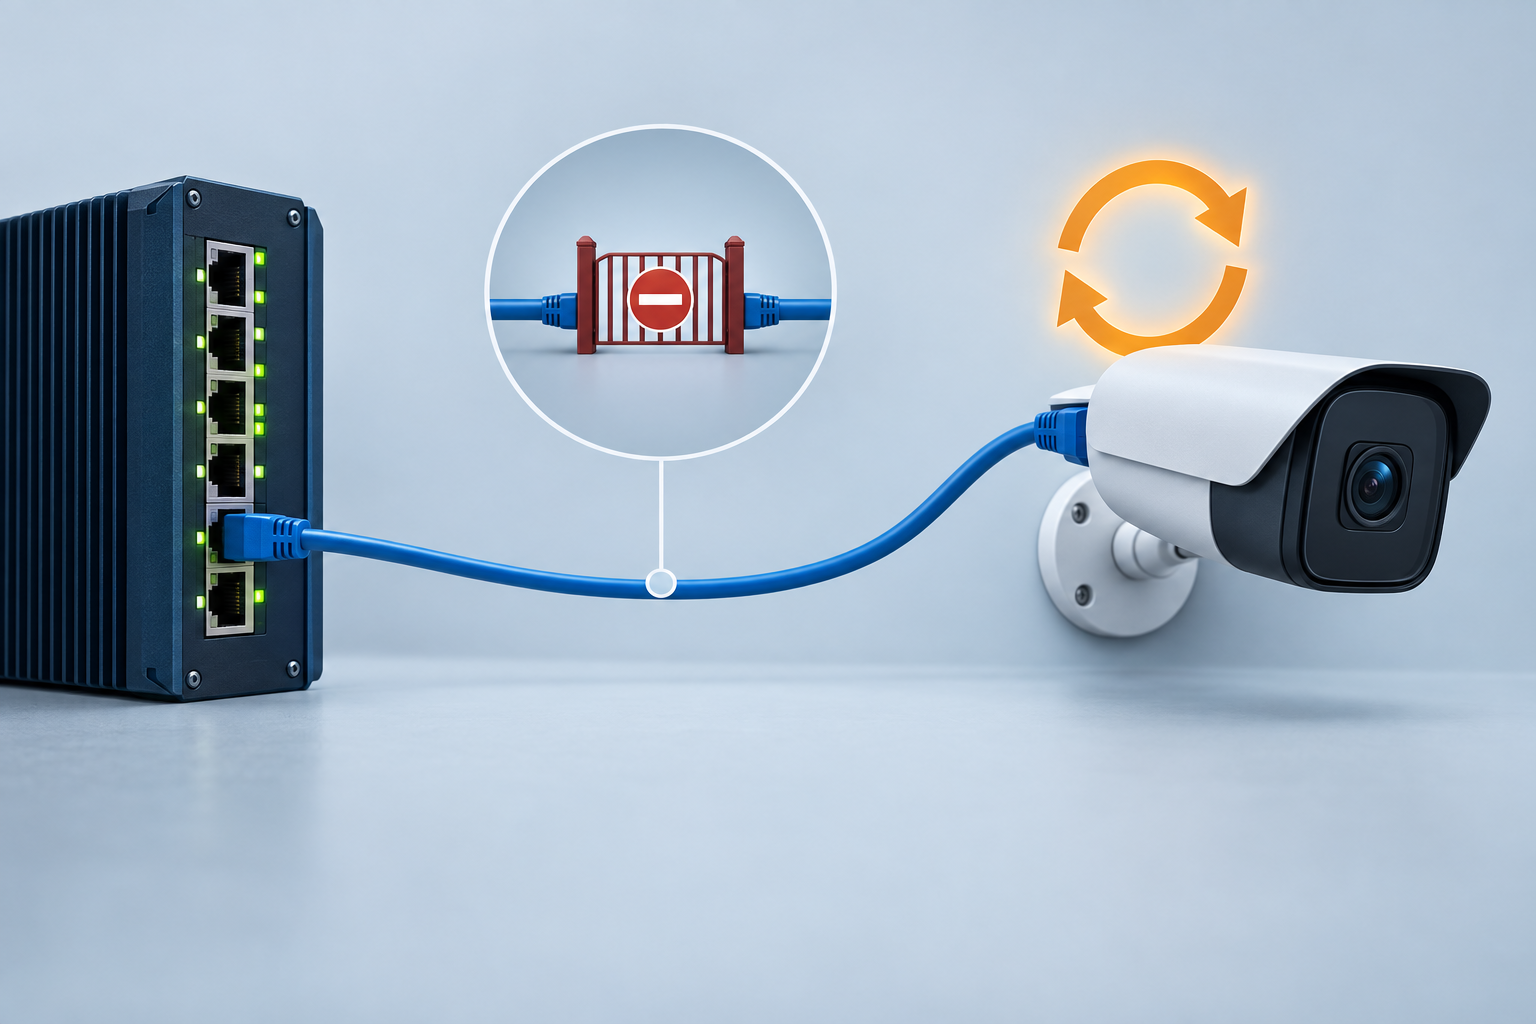
Pruebe la sonda desde el lugar correcto.
Que un portátil haga ping a la cámara correctamente no demuestra que el sistema de vigilancia pueda acceder a ella. El portátil podría estar en la VLAN de la cámara, mientras que la interfaz de gestión del switch se encuentra en otra. Una regla de acceso podría permitir el acceso al portátil, pero bloquear el acceso al switch. Además, el dispositivo de destino podría responder de forma diferente a la comprobación específica que utilice el switch.
Consulte la documentación del switch para verificar la interfaz de origen y el comportamiento de sondeo compatible. Compruebe la dirección de destino, la subred, la pertenencia a VLAN, el enrutamiento y las reglas de acceso pertinentes. Si la cámara obtuvo una nueva dirección mediante DHCP, es posible que el destino fijo del watchdog ahora apunte a otro dispositivo o a ninguno.
No solucione esto desactivando la segmentación de forma generalizada ni abriendo accesos innecesarios. Establezca la comunicación específica que requiere la función de recuperación aprobada. Si la función no puede operar en el diseño de gestión previsto, elija un sistema de monitorización compatible en lugar de debilitar toda la red que la rodea.
La captura de paquetes puede ser útil cuando la interfaz no ofrece suficiente información. Utilice un punto de observación autorizado y compruebe si las sondas salen, si las respuestas regresan y si la ruta de retorno llega al conmutador. Capture únicamente el tráfico necesario para el diagnóstico y conserve las marcas de tiempo que puedan compararse con los eventos de alimentación.
Analicemos un ejemplo de tiempos de inicio.
Supongamos que una cámara tarda 110 segundos después de restablecer la energía en responder con su configuración operativa habitual. Imaginemos que un sistema de vigilancia comienza a contar fallos después de 30 segundos, realiza comprobaciones cada 10 segundos y actúa tras tres fallos. Si las primeras comprobaciones se producen a los 30, 40 y 50 segundos, el sistema de vigilancia puede reiniciar la cámara mucho antes de que alcance el punto de preparación de 110 segundos.
Estas cifras ilustran un conflicto de sincronización; no son configuraciones recomendadas. La sincronización real de la primera prueba y la semántica del umbral dependen del conmutador. Mida el comportamiento de arranque de la cámara con los accesorios, el firmware y los servicios de red necesarios, y luego configure el límite permitido según corresponda.
Pruebe más que un simple reinicio rápido. Un arranque en frío, una comprobación de almacenamiento o el reinicio simultáneo de servicios ascendentes pueden tardar más. Mantenga el rango de arranque aceptado en el registro. Si un cambio de firmware modifica sustancialmente dicho rango, incluya el comportamiento del temporizador de vigilancia en la prueba de actualización en lugar de considerar el temporizador anterior como permanentemente correcto.
Separe un fallo de cámara de un fallo de ruta.
Diversas fallas pueden provocar la ausencia de respuesta. La cámara podría haberse bloqueado, su cable podría estar desconectado, la VLAN podría haber cambiado o la conexión de subida podría haber fallado. Reiniciar la cámara solo soluciona algunos de estos problemas.
Una comparación útil es el alcance del evento. Si todas las cámaras conectadas al mismo enlace fallan casi simultáneamente, un problema de alimentación o de ruta compartida requiere atención. Si una cámara pierde disponibilidad repetidamente mientras que los dispositivos vecinos permanecen estables, investigue ese dispositivo y su puerto. Estos patrones orientan la siguiente prueba; no son concluyentes por sí solos.
Evite habilitar reglas de recuperación agresivas idénticas en un grupo grande de cámaras sin un programa piloto. Una interrupción de red compartida podría provocar que varios conmutadores reinicien simultáneamente dispositivos que, de otro modo, funcionarían correctamente. El tráfico de arranque resultante y la pérdida de la cobertura grabada pueden prolongar la interrupción original.
Una respuesta de ping no certifica el servicio de vídeo.
El problema opuesto se presenta cuando una cámara responde al sistema de vigilancia mientras su transmisión no está disponible. La conectividad básica puede mantenerse incluso si falla una sesión de grabación, un proceso de codificación o una ruta de la aplicación. Aumentar el número de comprobaciones de ping no convierte esa comprobación en una prueba de estado del vídeo.
Defina qué necesita detectar el sitio. Si el requisito se refiere a la continuidad de la grabación, utilice la grabadora o un monitor de aplicaciones adecuado para supervisar dicho servicio. La función de recuperación del conmutador puede seguir siendo útil, pero su función debe especificarse con precisión. No presente una función básica de monitorización de accesibilidad como prueba de recuperación de vídeo de extremo a extremo.
Al evaluar unconmutador PoE industrialPregunte qué modelos y versiones de firmware específicos admiten la recuperación automática, qué elementos supervisan y qué configuraciones están disponibles. Una frase genérica como "vigilancia PoE" es insuficiente para diseñar la política de fallos.
Agregar un punto de parada a la recuperación automática
Un sistema de recuperación automática debe dejar constancia de su error cuando no pueda restablecer el servicio. Si es posible, utilice un límite de reintentos adecuado, un retardo creciente o una escalada de alarmas. Si el conmutador carece de estos controles, aborde esta limitación en el diseño general del sistema de monitorización en lugar de asumir que el reinicio continuo es aceptable.
Conserve el motivo de cada acción, el puerto afectado y la hora de interrupción y restablecimiento del suministro eléctrico, si están disponibles. Los intentos de recuperación fallidos repetidos constituyen información útil para el mantenimiento. Permiten identificar fallos persistentes en el cableado, un dispositivo inaccesible o uno que requiere atención.
Utilice los requisitos operativos locales para encontrar el equilibrio entre la velocidad de recuperación y los reinicios innecesarios. Una cámara remota sin un técnico cercano puede requerir una respuesta diferente a la de un dispositivo en una instalación con personal permanente. La política elegida debe justificarse en términos de disponibilidad del servicio y evidencia, y no simplemente por el deseo de usar el temporizador más corto que permita el menú.
Verifica la regla con fallas que tengan diferentes causas.
Para su aceptación, realice al menos los siguientes casos compatibles: un dispositivo que tarda en arrancar, un fallo real del punto final, una interrupción temporal de la ruta y un destino incorrecto o no disponible. Realice estas pruebas en un entorno de mantenimiento aislado o aprobado. Registre si se detectó el evento esperado, si se reinició la alimentación y si se restableció el servicio.
Verifique también que el caso sea saludable durante un período de observación suficiente. Una regla de recuperación que reacciona correctamente ante una falla forzada, pero que reinicia equipos en buen estado durante el tráfico normal, no está lista para su implementación. Compare la continuidad del registrador y el tiempo de actividad del punto final con el historial de eventos del conmutador.
El traspaso final debe incluir la dirección de destino, la ruta de sondeo, la justificación de la temporización, los límites de recuperación y el destino de la escalada. Cuando se produzca la siguiente interrupción repetida, este registro permite al operador distinguir un intento de reparación de la falla en sí, y modificar la parte correcta del sistema.
Fecha de publicación: 18 de septiembre de 2026


